
A semente média e os modos de variação.
Cada contorno vira uma lista de 128 números, e 130 sementes viram uma matriz. A decomposição em valores singulares dessa matriz dá a semente média, as direções em que as formas mais variam e quanto pesa cada direção. Nas sementes desta página, três direções guardam 92,8% da variação.
Aprofundar · matemática e referências
O contorno vira vetor
Para fazer álgebra com formas, cada semente precisa virar uma lista de números do mesmo tamanho. O jeito mais direto é andar sobre o contorno e marcar \(k\) pontos igualmente espaçados no comprimento de arco, como na página de Fourier. Aqui \(k = 64\), e a semente vira
Somar e subtrair esses vetores só faz sentido se o ponto \(j\) de uma semente corresponder ao ponto \(j\) de outra. Em semente quase não há marcos anatômicos visíveis no contorno, e os pontos igualmente espaçados fazem o papel deles: são os semimarcos de Bookstein [1], pontos que valem pela posição ao longo da curva e não por uma estrutura. Para que correspondam, falta escolher em que ponto o contorno começa, e essa escolha entra no alinhamento.
Definição
Duas configurações de \(k\) pontos têm a mesma forma quando uma vira a outra por translação, rotação e mudança de escala. Forma é o que sobra depois de tirar essas três coisas [2]. Nesta página tiramos também o espelho, porque a semente pode cair na placa com qualquer face para cima, e o ponto de partida do contorno.
Alinhar antes de comparar
A translação sai subtraindo o centroide. A escala sai dividindo pelo tamanho do centroide, a raiz da soma dos quadrados das distâncias dos pontos ao centro, que passa a valer 1. A rotação é o problema de Procrustes ortogonal: escrevendo cada semente como uma matriz \(k \times 2\), com uma linha por ponto, procurar a rotação \(R\) que deixa \(X\) o mais perto possível de uma referência \(M\).
Resultado 1 · a rotação ótima sai de uma SVD 2 × 2
Se \(X\) e \(M\) estão centradas e \(X^\top M = U\Sigma V^\top\), a rotação que minimiza \(\lVert XR - M \rVert_F\) é
Esboço. \(\lVert XR - M\rVert_F^2 = \lVert X\rVert_F^2 + \lVert M\rVert_F^2 - 2\operatorname{tr}(R^\top X^\top M)\), e só o traço depende de \(R\). Com \(Q = V^\top R^\top U\), que é ortogonal, \(\operatorname{tr}(R^\top U\Sigma V^\top) = \operatorname{tr}(\Sigma Q) = \sigma_1 q_{11} + \sigma_2 q_{22}\), e cada \(\lvert q_{ii}\rvert \le 1\). O máximo vem com \(Q = I\), isto é, \(R = UV^\top\) [3]. Se \(UV^\top\) for uma reflexão (determinante \(-1\)) e reflexões não forem permitidas, troca-se o sinal da última coluna, como em (2), e o traço cai de \(\sigma_1 + \sigma_2\) para \(\sigma_1 - \sigma_2\).
Com várias sementes não existe uma referência dada. O Procrustes generalizado [4] alterna dois passos: alinha cada semente à média atual e recalcula a média, até a média parar de mudar. Aqui, para cada semente e em cada rodada, testamos os 64 pontos de partida possíveis e a imagem no espelho, e ficamos com a combinação de menor distância. Com as 130 sementes, a média parou de mudar na sétima rodada.
A tabela mostra por que o alinhamento é a modelagem, e não um detalhe. São as mesmas 130 silhuetas, os mesmos 64 pontos e a mesma SVD. Só muda a correspondência.
| correspondência | variância total | PC1 | PC2 | modos para 95% |
|---|---|---|---|---|
| início sorteado, só centrar e escalar | 1,004 (×31,5) | 54,3% | 42,2% | 2 |
| início no ponto mais à direita, sem girar | 0,040 (×1,26) | 70,5% | 17,9% | 6 |
| Procrustes com ponto de partida e espelho | 0,032 | 88,5% | 2,6% | 5 |
Com o início sorteado, a variância total fica 31,5 vezes maior, e os dois primeiros modos, com 96,5% dela, descrevem só onde cada contorno começa. Parece um ótimo resultado (dois modos bastam) e é o pior: a PCA resume com fidelidade uma variação que não é de forma. A Figura 1 mostra as duas médias.
A semente média é a média dos vetores alinhados, \(\bar{\mathbf{x}} = \tfrac{1}{n}\sum_i \mathbf{x}_i\). Depois do Procrustes, ela minimiza a soma dos quadrados das distâncias às sementes alinhadas [2]. É diferente da semente média da página Aprender, que é a média das silhuetas pixel a pixel: a média de contornos é um contorno, e a média de silhuetas é um mapa de calor.
A matriz centrada, a SVD e o PCA
Empilhe as sementes alinhadas, cada uma menos a média, como linhas de uma matriz \(X\) de \(n \times 2k\). Aqui \(n = 130\) e \(2k = 128\). Toda matriz real tem decomposição em valores singulares [6]:
com \(U\) e \(V\) de colunas ortonormais e \(r\) o posto de \(X\). As colunas \(\mathbf{v}_i\) vivem no espaço das formas, \(\mathbb{R}^{128}\): são direções de deformação do contorno. As colunas \(\mathbf{u}_i\) vivem no espaço das sementes, \(\mathbb{R}^{130}\).
Resultado 2 · o PCA é a SVD da matriz centrada
A matriz de covariância das formas é \(S = X^\top X/(n-1)\). Então
Os componentes principais são as colunas de \(V\), as variâncias ao longo deles são \(\lambda_i\), e os escores de cada semente nos componentes são as linhas de \(T\) [5].
Esboço. \(X^\top X = V\Sigma U^\top U \Sigma V^\top = V\Sigma^2 V^\top\), porque \(U^\top U = I\). Isso já é a diagonalização de \(X^\top X\) por uma matriz ortogonal, e \(XV = U\Sigma V^\top V = U\Sigma\).
Nas 130 sementes, \(X\) tem posto 125, e não 128. Três valores singulares são zero na precisão da máquina (\(10^{-15}\) para baixo), e as direções correspondentes são exatamente as translações em \(x\) e em \(y\) e a rotação: o alinhamento já tirou essas três. Sobram no máximo 125 modos.
A melhor aproximação de posto r
Guardar só os \(r\) primeiros termos de (3) dá \(X_r = \sum_{i \le r} \sigma_i \mathbf{u}_i \mathbf{v}_i^\top\). Em formas, isso é aproximar cada semente pela média mais uma combinação dos \(r\) primeiros modos. O teorema diz que não existe jeito melhor.
Teorema de Eckart e Young
Para \(r \lt \operatorname{posto}(X)\),
Eckart e Young provaram a versão da norma de Frobenius em 1936 [7]. Mirsky estendeu o resultado a toda norma invariante por transformações ortogonais, inclusive a espectral [8].
Ideia da prova. A desigualdade de Weyl para valores singulares diz que \(\sigma_{i+j-1}(A + C) \le \sigma_i(A) + \sigma_j(C)\) [6]. Escreva \(X = (X - B) + B\) com \(\operatorname{posto}(B) \le r\), de modo que \(\sigma_{r+1}(B) = 0\). Com \(j = r + 1\) sai \(\sigma_{i+r}(X) \le \sigma_i(X - B)\) para todo \(i\). Somando os quadrados, \(\lVert X - B\rVert_F^2 = \sum_i \sigma_i(X - B)^2 \ge \sum_i \sigma_{i+r}(X)^2 = \lVert X - X_r\rVert_F^2\). Com \(i = 1\) sai a versão espectral.
É o mesmo enunciado da série de Fourier truncada: lá a base ortogonal é fixa (senos e cossenos), aqui a SVD escolhe a base ortogonal que melhor serve a estas sementes. A Figura 2 aplica a ideia a uma semente só.
Só com a média, a Amorpha fica a 6,3% do seu contorno. O primeiro modo acerta o alongamento (4,8%), e o lado reto do rim aparece no segundo (2,4%). Ela está a 4,2 desvios-padrão no PC2, entre as mais afastadas das 130, e por isso três modos ainda deixam 2,4% de erro. Na mediana das 130 sementes, a média sozinha erra 6,4% e a média com três modos, 1,4%.
Variância explicada
A fração da variância nos \(r\) primeiros modos é o quanto a aproximação de Eckart e Young preserva:
O primeiro modo leva 88,5% da variância. Os três primeiros, 92,8%; cinco chegam a 95,0%, dez a 97,9%, e para 99% são precisos 16. O erro relativo cai mais devagar, porque é a raiz do que falta: com três modos, 26,8%; com dez, 14,5%.
Autovalores estimados de uma amostra têm erro. Pela regra de North e colegas [9], o erro de amostragem de \(\lambda_i\) é da ordem de \(\lambda_i\sqrt{2/n}\), 12% com \(n = 130\). Quando dois autovalores vizinhos estão mais perto que isso, os dois modos podem trocar de lugar ou se misturar de uma amostra para outra, e só o plano que eles formam é confiável. Aqui \(\lambda_2/\lambda_3 = 1{,}48\) e \(\lambda_3/\lambda_4 = 1{,}46\): os três primeiros modos estão separados. Já \(\lambda_4/\lambda_5 = 1{,}19\) fica dentro da margem, e o quarto e o quinto modos não devem ser lidos um a um.
Por que calcular pela SVD
O jeito de livro de fazer PCA é montar a covariância \(X^\top X/(n-1)\) e achar os autovetores. O resultado é o mesmo de (4) na aritmética exata, mas não no computador. O número de condição de uma matriz, \(\kappa(A) = \sigma_{\max}/\sigma_{\min}\), mede quantos dígitos uma conta com ela pode perder.
Resultado 3 · montar \(A^\top A\) eleva o número de condição ao quadrado
Esboço. \(A^\top A = V\Sigma^2 V^\top\), então os valores singulares de \(A^\top A\) são \(\sigma_i^2\), e a razão entre o maior e o menor fica ao quadrado.
A consequência prática vem da teoria de perturbação [6][10]. Calcular os autovalores de \(X^\top X\) em aritmética de ponto flutuante, com precisão \(\varepsilon\), erra cada um por algo da ordem de \(\varepsilon\,\sigma_1^2\). Em termos relativos, \(\lambda_i\) pode errar até \(\varepsilon\,(\sigma_1/\sigma_i)^2\). A SVD de \(X\) erra cada \(\sigma_i\) por algo da ordem de \(\varepsilon\,\sigma_1\), e o erro relativo em \(\sigma_i^2\) fica na ordem de \(\varepsilon\,\sigma_1/\sigma_i\). A covariância gasta o dobro de dígitos nos modos pequenos.
Nas 130 sementes, \(\sigma_1/\sigma_{125} \approx 2{,}6 \times 10^4\), então \(\kappa^2 \approx 6{,}9 \times 10^8\). Em precisão dupla (cerca de 16 dígitos) as duas rotas dão os mesmos autovalores com folga: o pior erro relativo pela covariância é \(1{,}6 \times 10^{-9}\). Em precisão simples (cerca de 7 dígitos), a diferença aparece:
| modo \(i\) | \(\sigma_1/\sigma_i\) | pela SVD de \(X\) | pela covariância |
|---|---|---|---|
| 1 | 1 | 1 × 10⁻⁸ | 2 × 10⁻⁹ |
| 50 | 127 | 4 × 10⁻⁸ | 3 × 10⁻⁵ |
| 100 | 726 | 2 × 10⁻⁷ | 4 × 10⁻⁴ |
| 120 | 4.365 | 6 × 10⁻⁷ | 5 × 10⁻³ |
| 125 | 26.305 | 4 × 10⁻⁶ | 7 × 10⁻² |
O último modo sai com 7% de erro pela covariância e com 4 milionésimos pela SVD. Para os três modos desta página, qualquer rota serve. A folga some em matrizes piores, e o caso clássico é o dos mínimos quadrados: a equação normal \(Z^\top Z\boldsymbol\beta = Z^\top \mathbf{y}\) também eleva \(\kappa\) ao quadrado [10]. Na tabela pública de Koklu e colegas, com 106 descritores de forma e cor medidos em cerca de 75 mil grãos de arroz [11], a matriz de descritores tem \(\kappa(Z) \approx 1{,}0 \times 10^5\) e a equação normal chega a \(\kappa(Z^\top Z) \approx 1{,}0 \times 10^{10}\): montá-la gasta cerca de 10 dos 16 dígitos da precisão dupla. Por isso a regra é resolver pela SVD (ou por QR), sem formar \(Z^\top Z\).
Os modos de variação
Cada componente principal é uma direção de deformação. Andar \(b_i\) desvios-padrão ao longo dela, a partir da média, dá
É o modelo de distribuição de pontos dos modelos de forma ativos de Cootes e colegas, que limitam cada \(b_i\) a \(\pm 3\) [12]. Desenhados como imagens, os \(\mathbf{v}_i\) de rostos ficaram conhecidos como eigenfaces [13]. Aqui são eigen-sementes.
Lido nas formas, o PC1 é o alongamento: vai da semente redonda à fina e comprida, e o seu escore tem correlação 0,94 com a razão entre comprimento e largura. O PC2 deixa um lado mais reto e o outro mais curvo, o formato de rim. As duas Amorpha fruticosa estão em +4,2 e +4,5 desvios-padrão nele. O PC3 afina uma das pontas, como um ovo ou uma cunha, e a semente triangular de Amygdalus mongolica está em −4,6.
As sementes ocupam só um pedaço de cada eixo. No PC1, vão de −1,2 a +2,4 desvios-padrão. O modelo (8) é linear e continua desenhando fora disso: com \(b_1 = -2\) sai uma forma mais alta que larga, que nenhuma das 130 tem. É a distribuição que não é uma nuvem gaussiana em volta da média, e sim grupos (o arroz de um lado, a soja do outro).
Instrumento · deformar a semente média
Clique numa semente do plano, ou num ponto vazio para escolher b₁ e b₂.
A média, os três modos e os escores das 130 sementes foram calculados uma vez e estão embutidos na página; a deformação (8) é feita aqui, no seu navegador. Tracejado é a semente média; laranja, a forma com os pesos \(b_1\), \(b_2\) e \(b_3\), em desvios-padrão; em azul, o contorno alinhado da semente escolhida no plano. Ao escolher uma semente, os três controles vão para os escores dela, e a diferença entre o azul e o laranja é o que os outros 122 modos guardam.
No SeedCounter
No SeedCounter
O app faz um PCA de tamanho 2 × 2 em cada semente. A covariância das coordenadas dos pontos do contorno dá o eixo maior, e o comprimento e a largura são medidos ao longo dos dois autovetores, com a semente deitada. Para uma matriz simétrica 2 × 2 o autovetor tem fórmula fechada: o ângulo do eixo maior é \(\tfrac12 \operatorname{atan2}(2s_{xy},\, s_{xx} - s_{yy})\), a mesma conta do \(\theta_1\) da normalização de Fourier. Numa semente quase redonda o eixo fica mal definido, mas aí o comprimento e a largura quase não dependem dele.
O espaço de forma da página Aprender usa a mesma decomposição sobre as silhuetas inteiras, pixel a pixel, e lá o primeiro modo fica com cerca de metade da variação. Com contornos alinhados, o primeiro modo fica com 88,5%. A representação também decide o que a PCA vê.
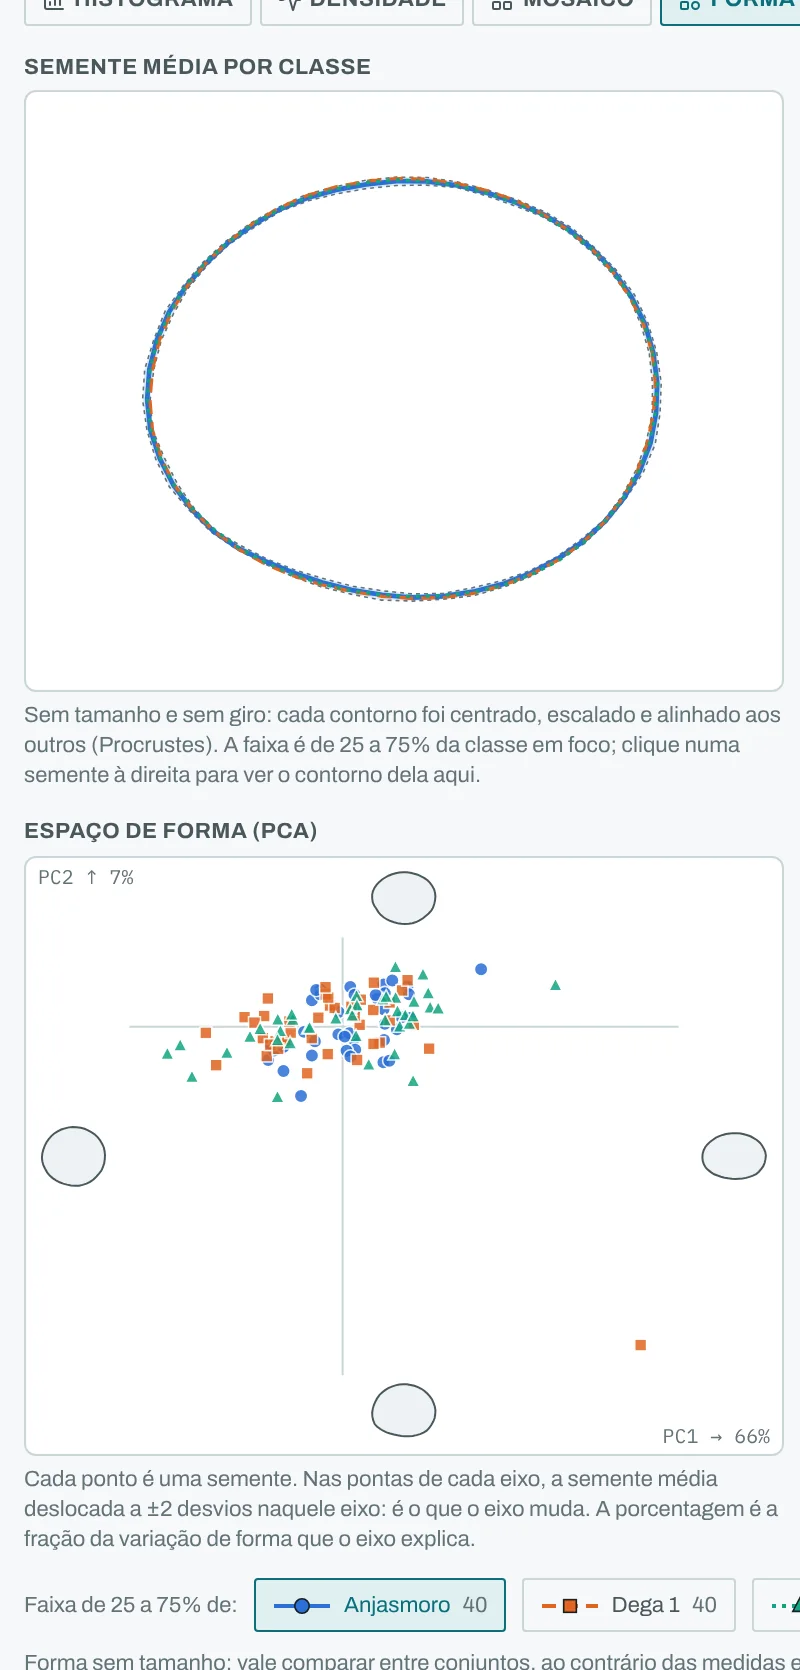
No hub de datasets, a vista Forma faz a conta desta página com um conjunto inteiro: cada contorno reamostrado em 48 pontos, alinhado por Procrustes, a semente média de cada classe com a faixa de 25 a 75% e o espaço de forma dos dois primeiros modos, onde clicar num ponto mostra a semente.
Onde falha
A PCA é mínimos quadrados, e quadrado pune o raro. Com as 145 silhuetas, incluindo as 15 de contorno recortado, o PC2 sobe de 2,6% para 19,3%, e cinco silhuetas (três nativas de contorno recortado, uma soja quebrada e uma de tegumento danificado) carregam 81% da variância dele. O segundo modo passa a descrever cinco sementes estranhas. Por isso as 15 ficaram de fora, com o critério escrito abaixo.
O modelo é linear e o conjunto é feito de grupos. Passos grandes ao longo de um modo saem do alcance das sementes, como a Figura 4 mostra. E as direções de maior variância não são, em geral, as que separam as classes: a PCA mostra, não decide. Separar classes é outro problema, e a página Quando a reta esconde uma classe mostra um caso em que a conta mais simples esconde uma delas.
A correspondência é uma escolha. Os 64 pontos igualmente espaçados não marcam o hilo nem a ponta da semente. Com marcos de verdade, os modos mudam.
Dados
Das 145 silhuetas de 64 × 64 px dos exemplos públicos do SeedCounter (arroz, soja, café, milho e espécies nativas), as mesmas da página Aprender, entram as 130 com solidez (área sobre a área do fecho convexo) de pelo menos 0,8: 40 de arroz, 31 de soja, 28 de café, 19 de espécies nativas e 12 de milho. Ficaram de fora 13 nativas e 2 sojas com recortes fundos, espinhos ou pedaços soltos. O contorno é o da página de Fourier, reamostrado em 64 pontos. O script que refaz as figuras está em _src/figuras/teoria-forma-svd.py.
Referências
- Bookstein F.L. (1997). Landmark methods for forms without landmarks: morphometrics of group differences in outline shape. Medical Image Analysis 1(3), 225–243. doi:10.1016/S1361-8415(97)85012-8
- Dryden I.L., Mardia K.V. (2016). Statistical Shape Analysis, with Applications in R, 2ª ed. Wiley.
- Schönemann P.H. (1966). A generalized solution of the orthogonal Procrustes problem. Psychometrika 31(1), 1–10. doi:10.1007/BF02289451
- Gower J.C. (1975). Generalized Procrustes analysis. Psychometrika 40(1), 33–51. doi:10.1007/BF02291478
- Jolliffe I.T., Cadima J. (2016). Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A 374(2065), 20150202. doi:10.1098/rsta.2015.0202
- Golub G.H., Van Loan C.F. (2013). Matrix Computations, 4ª ed. Johns Hopkins University Press.
- Eckart C., Young G. (1936). The approximation of one matrix by another of lower rank. Psychometrika 1(3), 211–218. doi:10.1007/BF02288367
- Mirsky L. (1960). Symmetric gauge functions and unitarily invariant norms. The Quarterly Journal of Mathematics 11(1), 50–59. doi:10.1093/qmath/11.1.50
- North G.R., Bell T.L., Cahalan R.F., Moeng F.J. (1982). Sampling errors in the estimation of empirical orthogonal functions. Monthly Weather Review 110(7), 699–706. doi:10.1175/1520-0493(1982)110<0699:SEITEO>2.0.CO;2
- Trefethen L.N., Bau D. (1997). Numerical Linear Algebra. SIAM.
- Koklu M., Cinar I., Taspinar Y.S. (2021). Classification of rice varieties with deep learning methods. Computers and Electronics in Agriculture 187, 106285. doi:10.1016/j.compag.2021.106285
- Cootes T.F., Taylor C.J., Cooper D.H., Graham J. (1995). Active shape models: their training and application. Computer Vision and Image Understanding 61(1), 38–59. doi:10.1006/cviu.1995.1004
- Turk M., Pentland A. (1991). Eigenfaces for recognition. Journal of Cognitive Neuroscience 3(1), 71–86. doi:10.1162/jocn.1991.3.1.71
Muitas sementes conferidas viram uma forma média.
O SeedCounter propõe o contorno de cada semente e você confere. É desse conjunto que a média e os modos saem.